- 九次测量下的平均遗憾值,BO9 / P1
- 0.213 / 0.272
- 补测一次的平均遗憾值,平均 9.61 次测量
- 0.162
- 补测候选对后已测最优,平均 11.43 次测量
- 0.122
King Arthur 这一题怎么选
《Once Upon a Time》中的 King Arthur 由哪位演员扮演?在这条 MuSiQue 归档案例中,Mistral 有八段候选证据,最终最多选三段。初始已测最优是 Liam Garrigan 的人物传记。加性模型建议把传记与 King Arthur 相关段落一起选入,单看各段分数,这个组合更有吸引力。
补测改变了选择。两段组合的估计效用为 1.574,实测为 0.206。单独使用传记已经测得 0.918,因此核验后选回传记。这里的效用以空上下文为基准,单位是每个参考答案词元的奈特。
-
查看初始测量
测量空上下文和八个单段上下文。段落 1 的人物传记是已测最优。
BO9 {1} → U = 0.918 -
用 P1 提出组合
加性模型根据单段增益选出人物传记和 King Arthur 相关段落。
P1 {1, 5} → A = 1.574 -
补测并作出选择
两段组合的实测效用低于传记单段。完成十次目标测量后,选回传记。
U({1, 5}) = 0.206 < 0.918 → {1}
解码后的答案给出了另一层证据。两段组合生成了完全匹配的简短答案,传记单段生成的答案词元 F1 为 0.444。这也是整个研究同时记录实测效用和答案质量的原因。
让预测器决定下一次测什么
给定上下文 S,目标生成模型对参考答案逐词元打分。每个词元的条件包括问题、按固定次序排列的证据,以及之前的参考词元。记这些对数概率的均值为 ℓ(S),中心化效用为 U(S) = ℓ(S) − ℓ(∅)。每测一个上下文就记一次目标测量。
初始观测包含空上下文和八个单段上下文。BO9 取其中实测效用最高者。P1 将单段增益相加,在最多选三段的 93 个可行子集中选出估计分数最高的组合。空上下文是中心化基准,因此单段增益就是单段的实测效用。
P1 + 一次核验沿用同一个候选组合。若候选此前未测过,就补测一次,再从初始观测与补测结果中选实测效用最高者。核验后的候选集合包含两种基础策略各自的选择,因此最终实测效用至少达到两者的水平。分数并列时取整数掩码最小者。
选择完成后,评估器才使用完整效用数组。归一化遗憾值是所选集合与可行最优集合的效用差,除以数据集、生成模型及候选池构造对应的冻结尺度。核验保证的是已测集合中的实测效用,遗憾值衡量与全部可行子集中最优者的距离。
同样九次测量,怎样选?
主比较固定每个问题、八段候选池和生成模型,最终上下文至多选三段。180 道留出问题、两种候选池和四个生成模型构成 1,440 个配对设置。在同样九次测量下,已测最优的平均归一化遗憾值为 0.213,加性策略为 0.272。按实测效用比较,加性策略有 324 次更好、552 次更差、564 次相同。
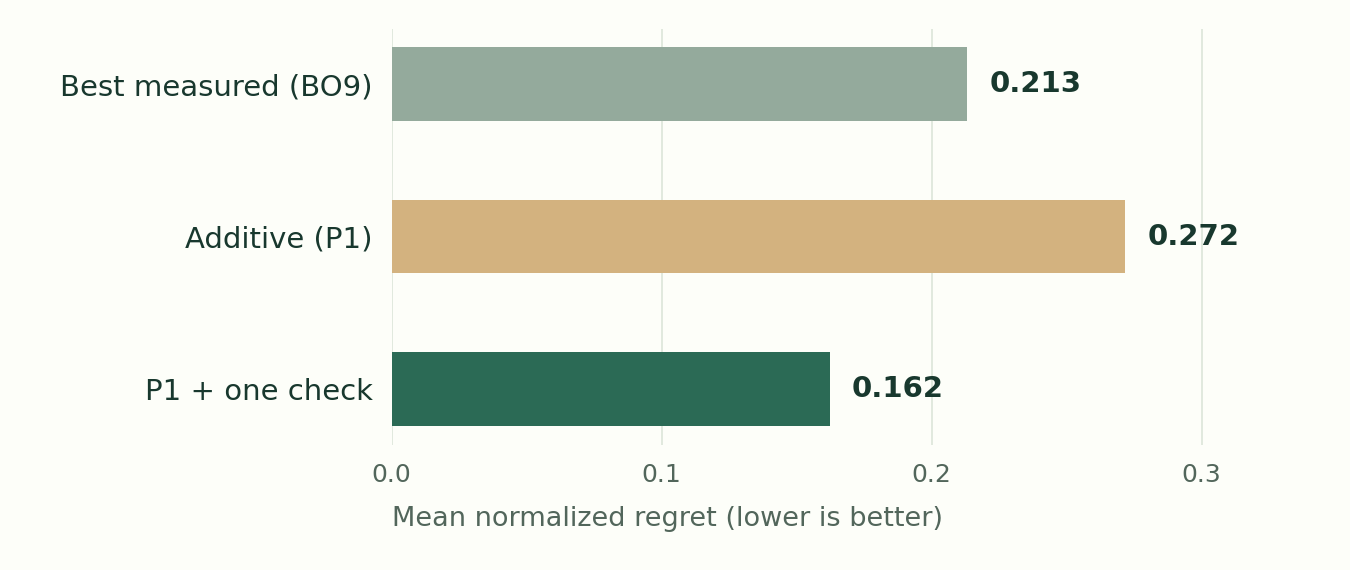
同一批 1,440 个八段候选设置,最多选三段。平均归一化遗憾值越低越好,各策略的测量成本见下表。
有 876 个设置需要对新候选补测一次。之后从已测上下文中选最优,平均遗憾值为 0.162,平均目标测量次数为 9.61。相对 P1,配对差为 −0.109,95% 区间为 [−0.138, −0.085]。相对 BO9,配对差为 −0.051 [−0.078, −0.031]。
| 策略 | 平均效用测量次数 | 归一化遗憾值 ↓ | 词元 F1 ↑ | 答案完全匹配率 ↑ |
|---|---|---|---|---|
| 已测最优(BO9) | 9.00 | 0.213 | 0.586 | 0.444 |
| 加性策略(P1) | 9.00 | 0.272 | 0.554 | 0.422 |
| P1 + 一次核验 | 9.61 | 0.162 | 0.592 | 0.453 |
贪心解码的词元 F1 相对 P1 提高 0.038 [0.020, 0.056],相对 BO9 提高 0.006 [−0.003, 0.015]。对 BO9 的答案完全匹配率区间也包含零。这说明在这批案例里,效用遗憾值的改善比答案指标的变化更明确。
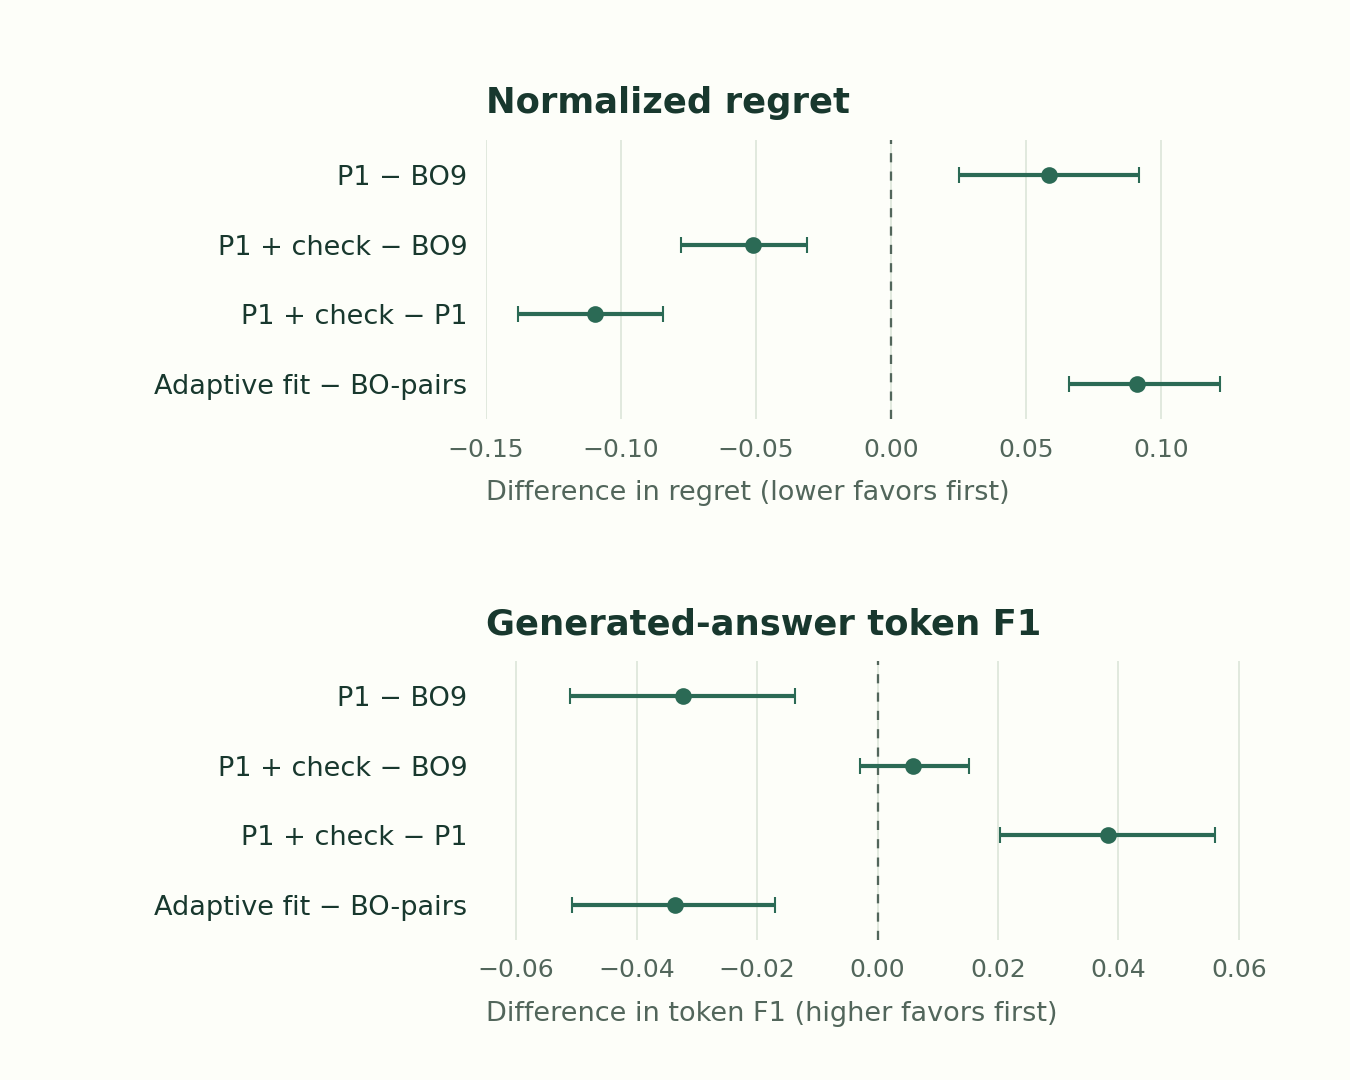
圆点表示配对均值差,线段表示按问题聚类的 95% Bootstrap 区间。每行是前一策略减后一策略。BO-pairs 表示补测候选对后保留已测最优。两图横轴刻度独立。
| 前一策略减后一策略 | 归一化遗憾值差 | 词元 F1 差 | 答案完全匹配率差 |
|---|---|---|---|
| 加性策略(P1) − 已测最优(BO9) | +0.059 [+0.025, +0.092] | −0.032 [−0.051, −0.014] | −0.023 [−0.044, −0.001] |
| P1 + 一次核验 − 已测最优(BO9) | −0.051 [−0.078, −0.031] | +0.006 [−0.003, +0.015] | +0.009 [−0.001, +0.021] |
| P1 + 一次核验 − 加性策略(P1) | −0.109 [−0.138, −0.085] | +0.038 [+0.020, +0.056] | +0.032 [+0.013, +0.051] |
| 自适应二次拟合 − 补测对后取已测最优 | +0.091 [+0.066, +0.122] | −0.034 [−0.051, −0.017] | −0.021 [−0.040, −0.002] |
哪些组合在补测后会被保留
另一条归档案例询问《奥尔南的葬礼》创作者的出生日期。对这条 MuSiQue 问题,Qwen 使用画作相关单段时效用为 3.953。P1 提出的三段组合实测为 4.491,达到可行最优,因此核验后保留三段。两种上下文的词元 F1 都是 0。
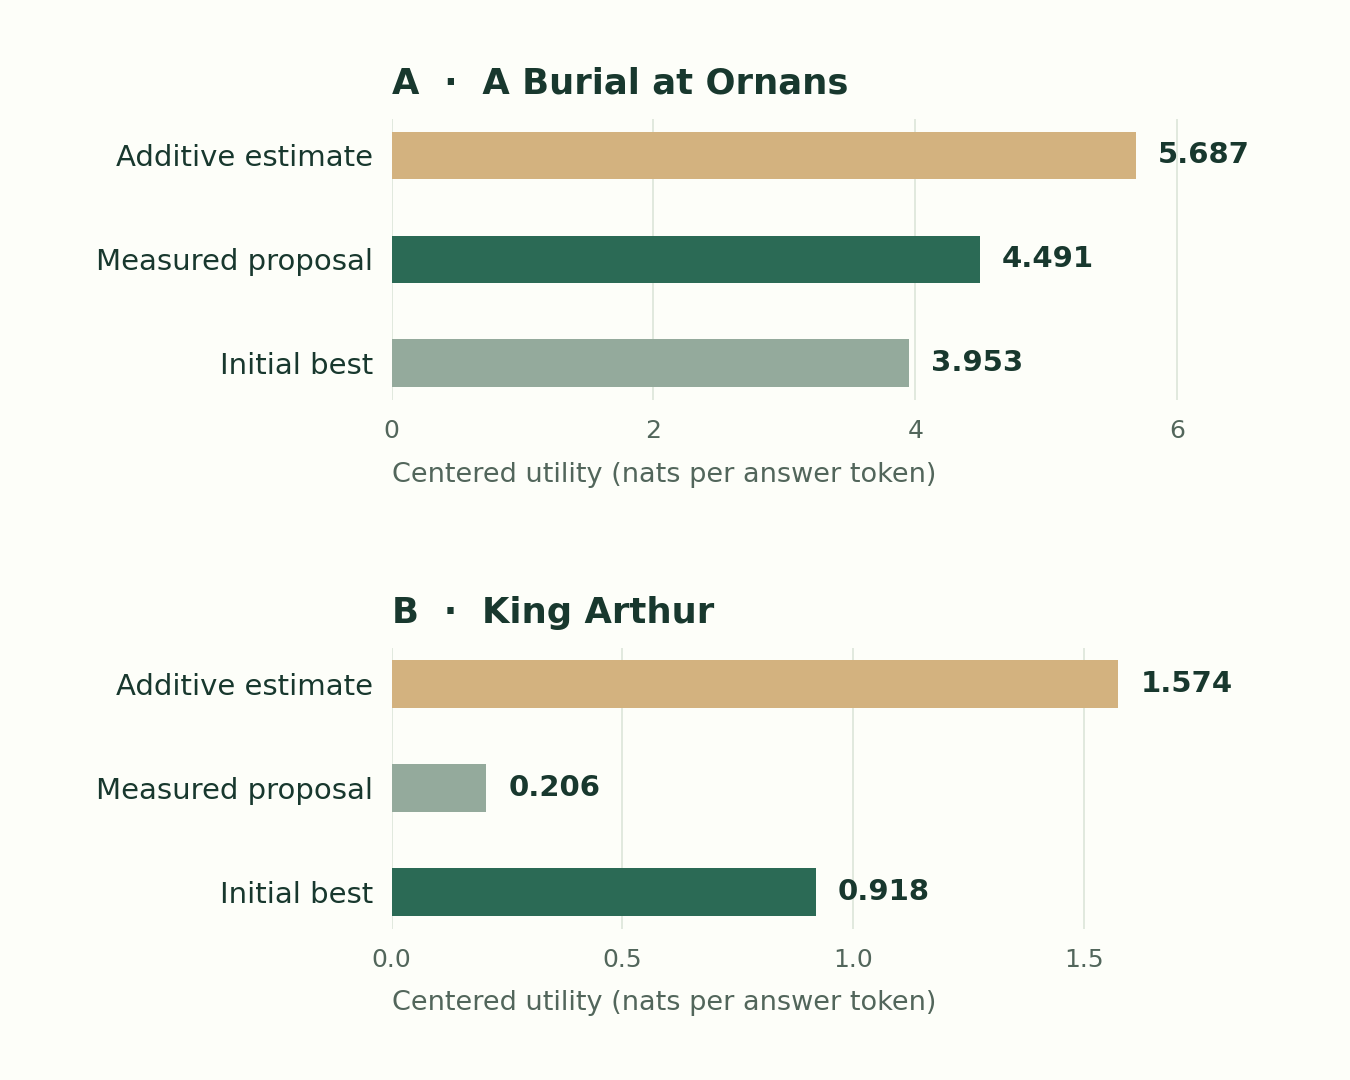
A 为 MuSiQue 问题 2hop__107905_110222(Qwen),B 为 2hop__10620_49084(Mistral)。绿色条是核验后的选择,两图横轴独立。
奥尔南画作案例与开篇的 King Arthur 案例来自 Track B 的 720 个设置。选例只考虑 P1 提出多段的情况,按相对 BO9 的归一化遗憾值至少改善或恶化 0.05 分组,再分别取最接近组内中位数的案例。两组分别有 105 个改善设置与 185 个恶化设置。表中列出了归档键、实际选择及答案评分。
| 案例 | 策略 | 段落编号 | 实测效用 | 词元 F1 | 答案完全匹配 |
|---|---|---|---|---|---|
| A | 已测最优(BO9) | 6 | 3.953 | 0.000 | 0 |
| A | 加性策略(P1) | 4, 5, 6 | 4.491 | 0.000 | 0 |
| A | P1 + 一次核验 | 4, 5, 6 | 4.491 | 0.000 | 0 |
| B | 已测最优(BO9) | 1 | 0.918 | 0.444 | 0 |
| B | 加性策略(P1) | 1, 5 | 0.206 | 1.000 | 1 |
| B | P1 + 一次核验 | 1 | 0.918 | 0.444 | 0 |
多测候选对时,哪一步带来收益
自适应规则以无上下文分数的相反数作为触发指标。达到开发数据的合并中位数(约 7.2883)时,就测量加性模型排名前四的候选组合中出现的所有不重复证据对。二次拟合在加性分数上加入每个实测对超出两个单段分数之和的效用,未测对的效应设为零。
二次拟合策略与「补测对后取已测最优」看到完全相同的分数,平均都是 11.43 次测量。拟合策略选出的集合平均归一化遗憾值为 0.213,保留已测最优可到 0.122,配对改善 0.091 [0.066, 0.122]。再核验二次模型提出的候选,则得到另一个成本点,平均 11.94 次测量、遗憾值 0.109。
| 策略 | 平均效用测量次数 | 归一化遗憾值 ↓ | 词元 F1 ↑ | 答案完全匹配率 ↑ |
|---|---|---|---|---|
| 自适应二次拟合 | 11.43 | 0.213 | 0.557 | 0.429 |
| 补测对后取已测最优 | 11.43 | 0.122 | 0.590 | 0.450 |
| 自适应拟合 + 一次核验 | 11.94 | 0.109 | 0.590 | 0.455 |
| 随机证据对 | 11.43 | 0.277 | — | — |
| 按哈希选子集 | 11.43 | 0.377 | — | — |
| 全证据对拟合 | 37.00 | 0.271 | 0.538 | 0.402 |
两个同成本对照分别按哈希顺序补测证据对或子集,平均遗憾值为 0.277 和 0.377。测完 28 个证据对再加初始九个上下文,共需 37 次测量。全证据对拟合的平均遗憾值为 0.271,与 P1 的配对差区间包含零。在这组同测量对照中,补测有时会直接找到可以保留的更好上下文。
效用有交互,选择仍可以很简单
给已有集合再加入一段证据,有时会降低效用。在同一个基底集合上,两段同时加入的增益也可能超过分别加入的增益之和。论文表 4 在可行域内检验这两种效应,只计入幅度超过冻结实质阈值的变化。三段预算下,有害边际增益的平均比例为 34.7%,递增收益为 45.2%。
| 可行域 | 负边际增益 | 正二阶差分 |
|---|---|---|
| 最多 3 段 | 34.7% | 45.2% |
| 最多 4 段 | 32.5% | 39.3% |
| 八段完整集合 | 31.2% | 35.4% |
选择由实际竞争的集合决定。设 A 是加性预测,I = U − A 是残差。一个候选要超过加性最优,必须用额外的残差增益抵消加性分数的劣势。King Arthur 案例中,两段组合的加性优势在补测后消失。候选池其他地方即使存在很强的交互,也可能不改变这两个集合的顺序。
候选池变大后,核验还有帮助吗
第一项检验在同一批原始候选池上取前四、六、八段,选择预算仍为三段。核验策略的平均遗憾值依次为 0.074、0.126、0.162,在三种候选池大小下都低于初始已测最优策略。
另一个配对扩展在 Track B 中按哈希选取 20 道 MuSiQue 问题,并用 Qwen 和 Gemma 评分。保留原八个位置,再追加四个检索名次。每个候选池大小都有 40 个配对的问题–模型设置,十二段下有 299 个可行上下文。此时核验策略平均测量 13.80 次、遗憾值 0.227,初始已测最优平均测量 13.00 次、遗憾值 0.275。配对遗憾值差为 −0.048 [−0.099, −0.017]。
| 策略 | 8 段候选 | 12 段候选 |
|---|---|---|
| 初始已测最优 | 0.252 (9.00) | 0.275 (13.00) |
| 加性策略(P1) | 0.295 (9.00) | 0.378 (13.00) |
| P1 + 一次核验 | 0.172 (9.75) | 0.227 (13.80) |
| 自适应二次拟合 | 0.304 (12.82) | 0.331 (17.38) |
| 补测对后取已测最优 | 0.168 (12.82) | 0.184 (17.38) |
这些结果把比较扩展到了一个检索设置下的十二段候选。原八段实验的四段选择预算是另一项检查。在该预算下,加性核验的平均遗憾值为 0.186,选测候选对后保留已测最优为 0.142。
这些测量的适用范围
原实验从 HotpotQA、2WikiMultiHopQA、MuSiQue 各取 60 道留出题。Track A 保留标注支持段并用 BGE 补齐,Track B 对数据集内 BM25 与 BGE 名次做倒数排名融合。固定段落表示最多使用 256 个 Qwen2.5 词元。每个候选池都在 Qwen2.5-7B-Instruct、Gemma-3-4B-IT、Mistral-7B-Instruct-v0.3 和 Phi-4-Mini-Instruct 上测量。
遗憾值的尺度来自冻结的六段校准数组。95% 配对区间按 180 个问题做 10,000 次 Bootstrap 重抽样,同一道题的两个候选池和四个模型始终成组。答案 F1 和完全匹配率使用贪心解码和规范化参考答案别名。公开归档按上下文键提供对应分数。
该效用需要参考答案,因此选择规则适用于带标注的离线评估。测量次数对应目标打分调用,实际耗时还取决于段落长度与解码。若要用于在线检索,需要独立于参考答案的效用信号和对应验证。
先跑通一个案例,再复现论文结果
下面的案例入口使用 Python 3.9 或更新版本的标准库。它从公开归档读出 King Arthur 案例的候选组合、实测效用与答案分数。加上 --case ornans 可复现另一条案例。
git clone --depth 1 https://github.com/dqswordman/rag-decision-sufficiency.git
cd rag-decision-sufficiency
python code/inspect_case.py
复现论文结果时使用固定的 v1.0.0 版本。干净环境的 CPU 验证检查了 41 个输入哈希,匹配 22 份结果 CSV 与 4 张论文表,并重新生成了遗憾值分布图。复现指南列出每张论文表对应的设置和输出文件。
资料与数据
版本 1.1 · 补全真实案例、同预算对照与 CPU 复现步骤。