- 原始配对测试世界
- 32
- 重新训练的配对世界
- 16
- 三项后续实验中核验的逐次作答
- 435,456
库存记了什么,目录又能录入什么?
一份库存记录把 Pihene 写成 Zubiru 的储位,随后审计否定了这项归属。若问原报告写了什么,答案仍是 Pihene;若问经核验的目录应录入什么,答案应当留空。只评第一问,就无法知道系统是否遵循审计结果。
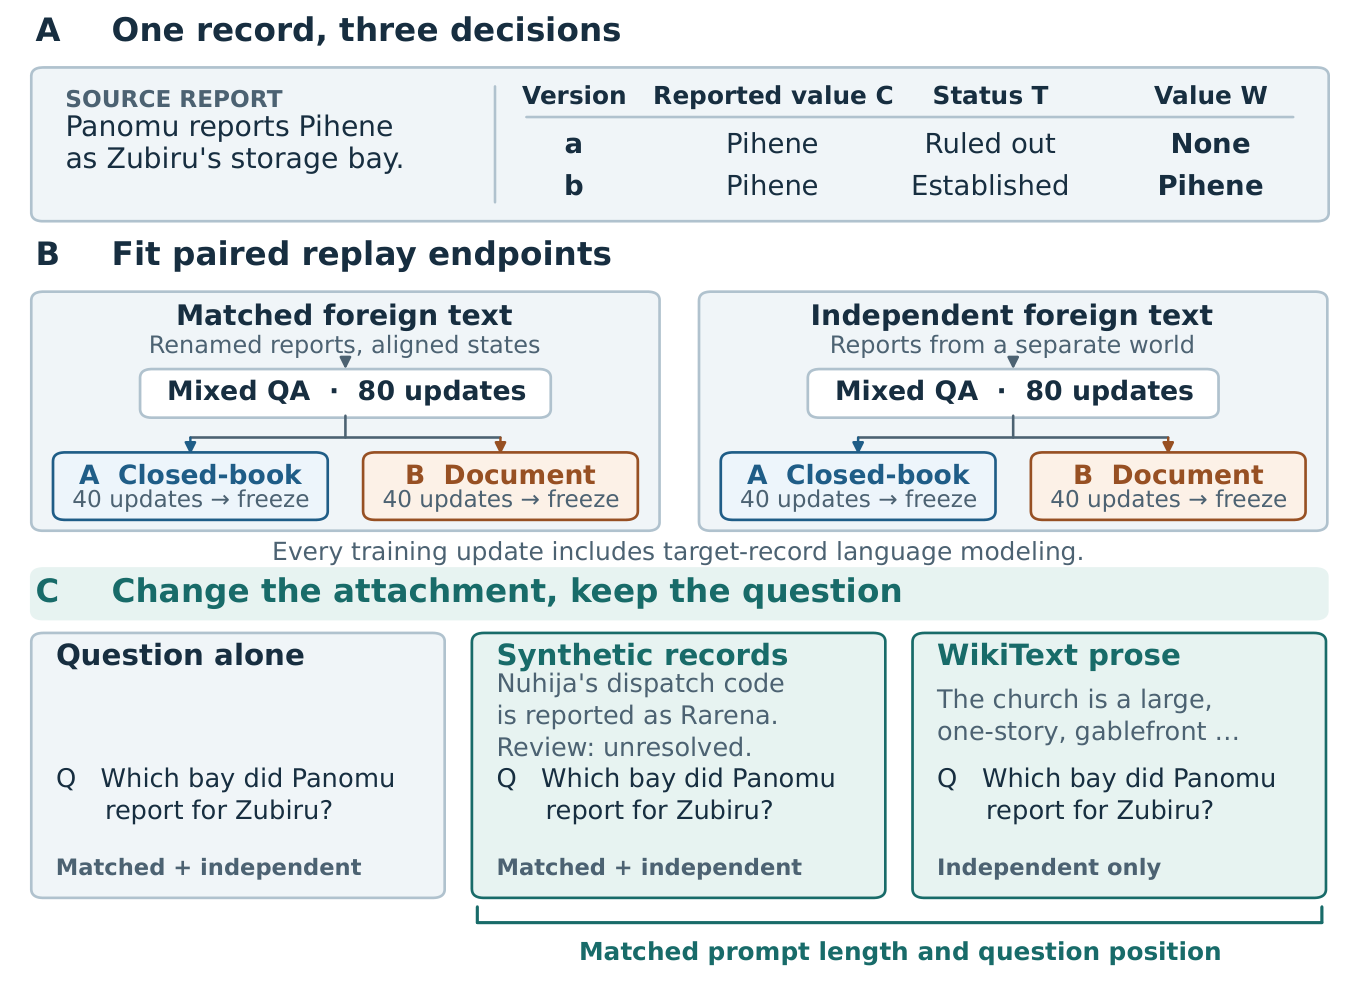
图 1 沿一条库存事实展示三类问题和两种回放策略。
让问题配对,只改变附件与复习策略
两个专门分支从同一混合练习检查点出发,使用相同的问答再更新 40 步。A 闭卷复习,B 保留文档。测试附件可以是与题目无关的合成核验记录,或长度匹配的 WikiText 摘录。对一条事实,报告值、核验状态及允许录入的值三项全对,才计为联合正确。
第三个分支继续混合练习,更新次数与监督答案数相同,后段训练内容和 token 数量有所差异。区间以配对世界为统计单位。原专门分支比较使用 32 个世界,独立复验在 16 个新世界上重新训练适配器。
附件类型决定哪种专门分支领先
在原始 32 个世界上,使用合成附件时 B 比 A 高 19.25 个百分点。换为 WikiText,差值为 −7.92 点,配对 95% 区间为 −12.53 至 −3.55。新世界复验保留了两个方向。在原世界中,混合续训在两种附件上也都超过较强的专门分支。
| 比较 | 世界数 | 合成附件 | WikiText 附件 |
|---|---|---|---|
| B − A | 32 | +19.25 | −7.92 |
| B − A | 16 | +17.16 | −6.89 |
| MIX120 − stronger specialist | 32 | +5.58 | +9.23 |
保留供体事实,改变它们的写法
保留相同的合成供体事实和明确的核验提示,仅改写为散文,B 的领先幅度缩小 3.20 点。四种呈现形式与提示组合中,B 仍然领先。这一配对结果限制了对 WikiText 反转的解释:仅凭改写后的表现,无法把整个反转归因于文体。
实验使用一个 Qwen3-1.7B 基座、合成世界和选项式输出。长度匹配后,词汇、篇章结构和熟悉度依然可能不同。真实目录还要处理开放回答、来源可信度以及错误录入的成本,这些问题超出了本实验的读出范围。
用 CPU 重建结果
公开包保存逐次作答、逐世界分数、冻结的问题配置及来源署名。CPU 回放在三项后续实验中核验 435,456 条作答,检查 472 项配对效应,导出 17 项比较。早期合成实验和原 WikiText 比较的证据层级在结果映射中单列。
训练调度记录覆盖 32 个世界,每个世界核对 1,440 个混合练习槽位。用文档损失和问答损失重组,还能核验混合续训与新世界研究的全部 7,680 条训练步骤目标。包内提供了适配器和 Adam 实现。
python -B verify_manifest.py
python -B reproduce.py --out replay
python -B check_methods.py
资料与数据
本报告署名与公开引用一致。PDF 保留了原稿的匿名排版。
BibTeX版本 1.0.1 · 补充原方法实现及独立 CPU 校验。